MZP Knowledge Engine · Diagram-Design Report · 2026-08-16
27 Diagrammtypen einer modernen Data & Analytics Plattform
Jeder der 27 nativen MZP-Diagrammtypen an einem durchgehenden Thema erklaert: vom ersten Quellsystem bis zur RBAC-Zugriffsmatrix. Alle Diagramme sind serverseitig ueber die MZP-Diagramm-Engine gerendert (kein handgezeichnetes SVG), Zahlen sind recherchiert und im Quellenverzeichnis unten belegt.
Inhalt
01 · Architektur
Data-Platform-Referenzarchitektur
Von Quellsystemen bis Konsum: Ingestion, Medallion-Speicherlayer und Governance in einem Bild.
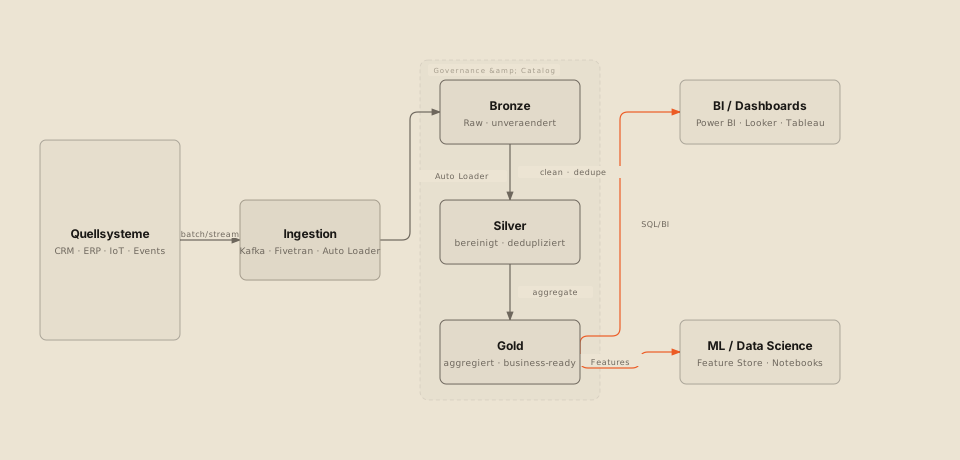
Governance & Catalog umschliesst alle drei Speicher-Layer als Zone — kein Zugriff läuft am Katalog vorbei.
02 · IT-State
Betriebszustaende einer Pipeline-Instanz
Health-Zustandsautomat einer Ingestion-Pipeline: von gesund bis Ausfall und Selbstheilung.
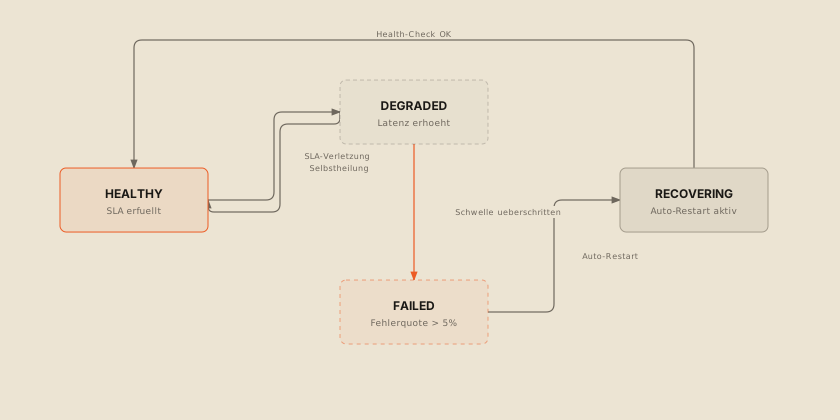
RECOVERING ist ein eigener, sichtbarer Zustand — kein stiller Neustart, sondern ein beobachtbarer Schritt im Health-Check.
03 · Routing-Entscheidung
Streaming oder Batch?
Wie neue Datenquellen in die Ingestion-Schicht geroutet werden.
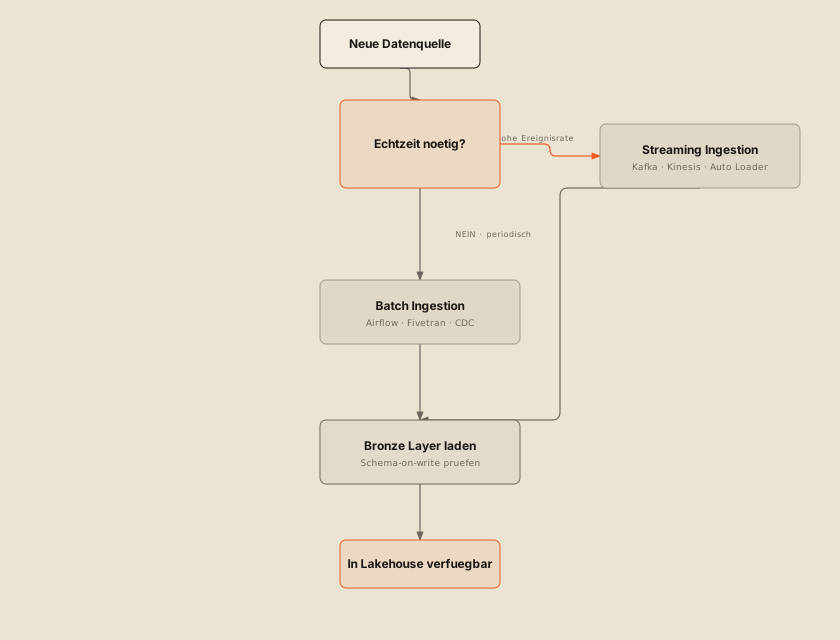
Die Entscheidung faellt pro Quelle, nicht pro Plattform — beide Pfade landen im selben Bronze-Layer.
04 · Ablauf
BI-Query-Sequenz
Vom Dashboard-Klick bis zum gecachten Result Set.
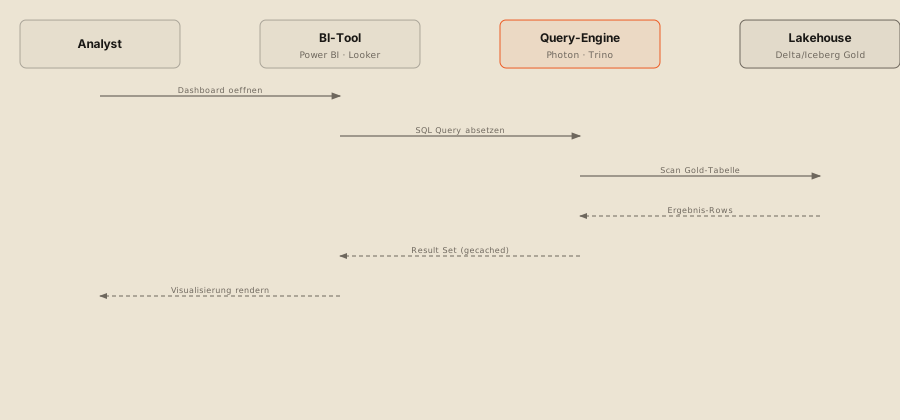
Das Result Set wird serverseitig gecacht — wiederholte Dashboard-Aufrufe treffen selten die Lakehouse-Storage direkt.
05 · Zustand
Orchestrator-Task-Zustandsautomat
Wie ein Airflow/Dagster-Task von Queued bis Success oder Retry laeuft.
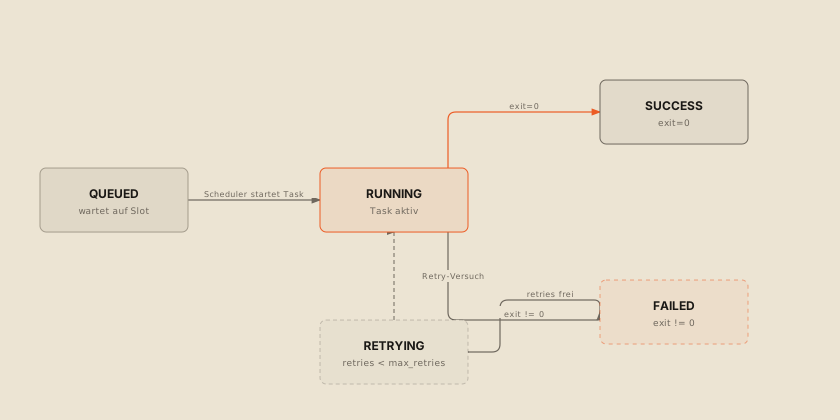
RETRYING ist ein eigener Zustand, kein Sonderfall von RUNNING — das macht Retry-Budgets beobachtbar.
06 · Datenmodell
Star-Schema: FACT_SALES
Klassisches dimensionales Modell in der Gold-Schicht.
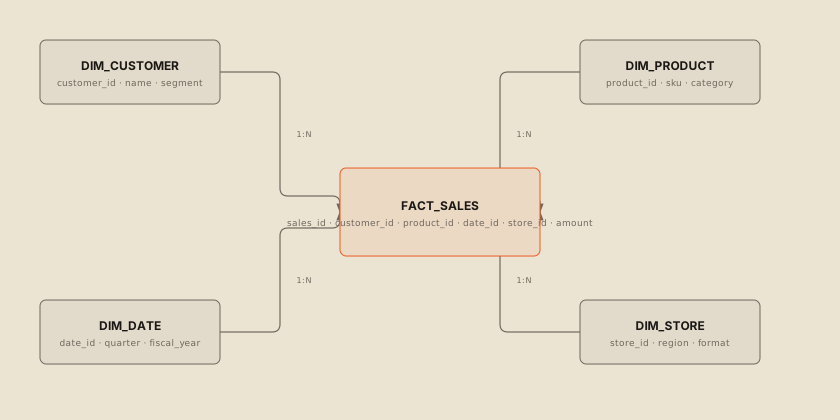
Vier Dimensionstabellen, eine Faktentabelle — das klassische Muster fuer performante BI-Abfragen im Gold-Layer.
07 · Zeitachse
Evolution der Data-Platform-Technologien
Von Hadoop-Batch-Verarbeitung zu agentenfaehigen Lakehouse-Plattformen.
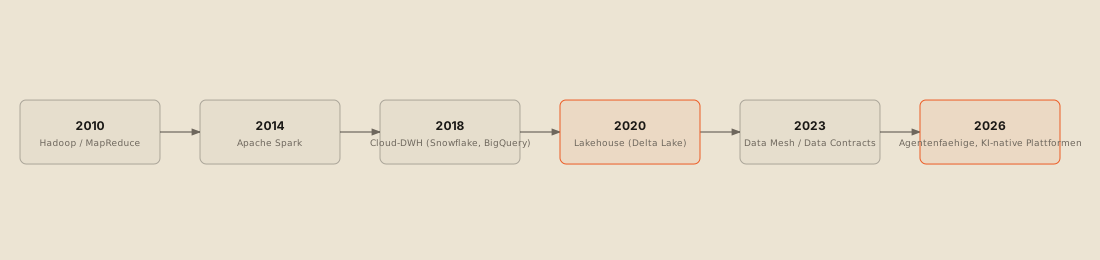
Jede Welle loeste nicht die vorherige ab, sondern baute eine Schicht darueber — Spark laeuft heute noch unter jedem Lakehouse.
08 · Swimlane
Verantwortlichkeiten entlang der Pipeline
Wer macht was zwischen Ingestion und Self-Service-BI.
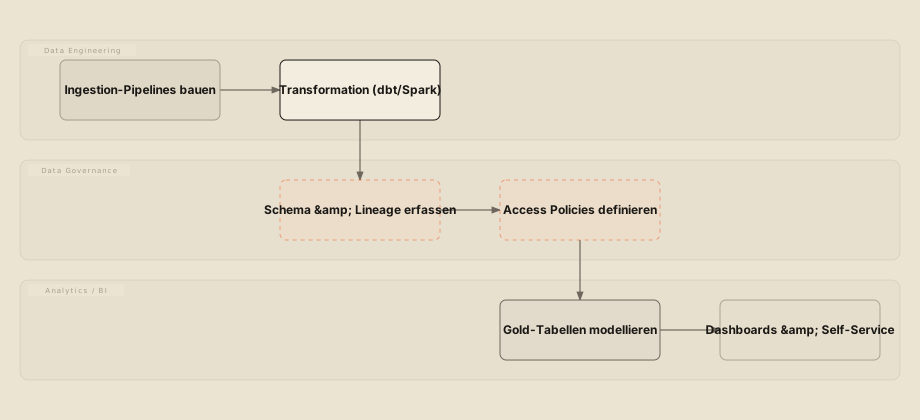
Data Governance sitzt bewusst zwischen Engineering und Analytics, nicht daneben — Lineage entsteht dort, wo Daten den Besitzer wechseln.
09 · Vergleich
Positionierung der Cloud-Datenplattformen
X: Setup-Komplexitaet · Y: AI/ML-natives Tooling — illustrative Einordnung nach oeffentlicher Produktausrichtung.
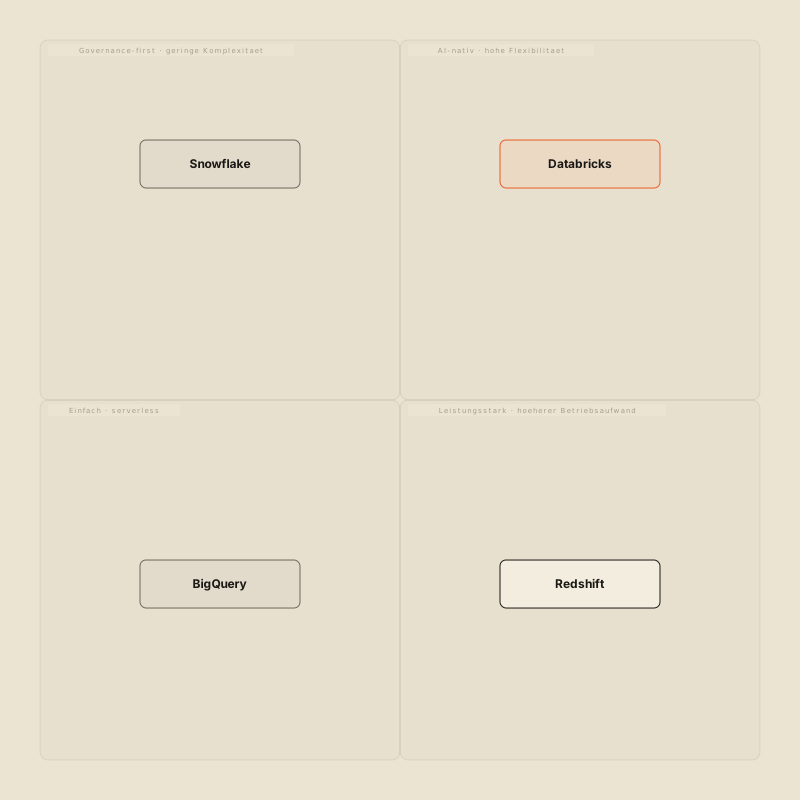
Die Grenzen verschieben sich: Snowflake baut AI-Funktionen aus, Databricks vereinfacht Governance — 2026 ist das keine feste Landkarte.
10 · Kompetenzprofil
Skills-Radar: Data Engineer
Typisches Faehigkeitsprofil in einem modernen Data-Engineering-Team.
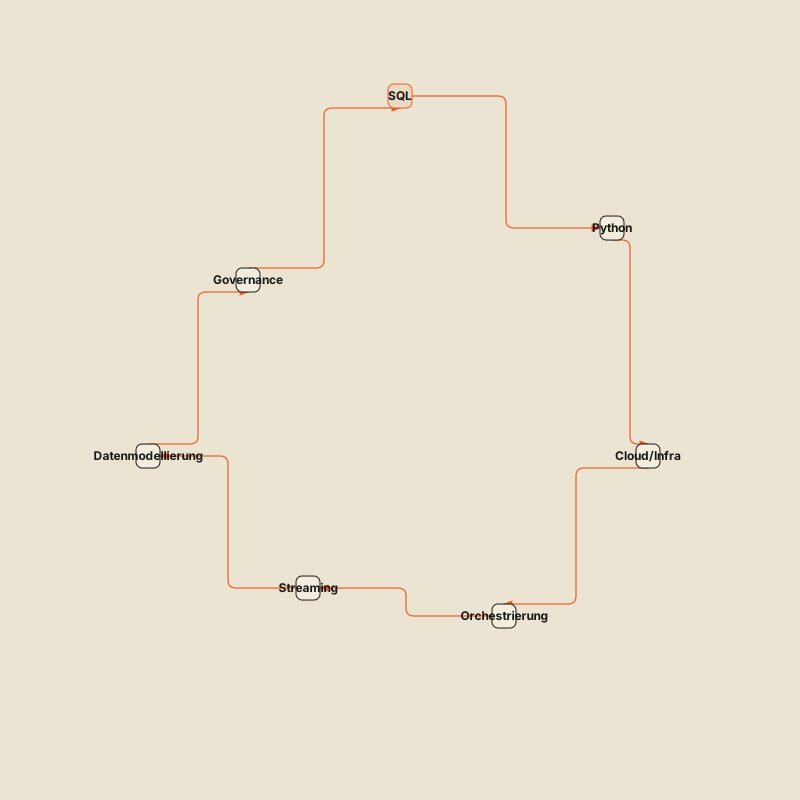
SQL bleibt die hoechste Kompetenz-Achse — auch nach zehn Jahren Big-Data-Tooling.
11 · Kreislauf
MLOps-Feedback-Loop
Kontinuierliches Training, Deployment und Monitoring auf Basis der Gold-Daten.
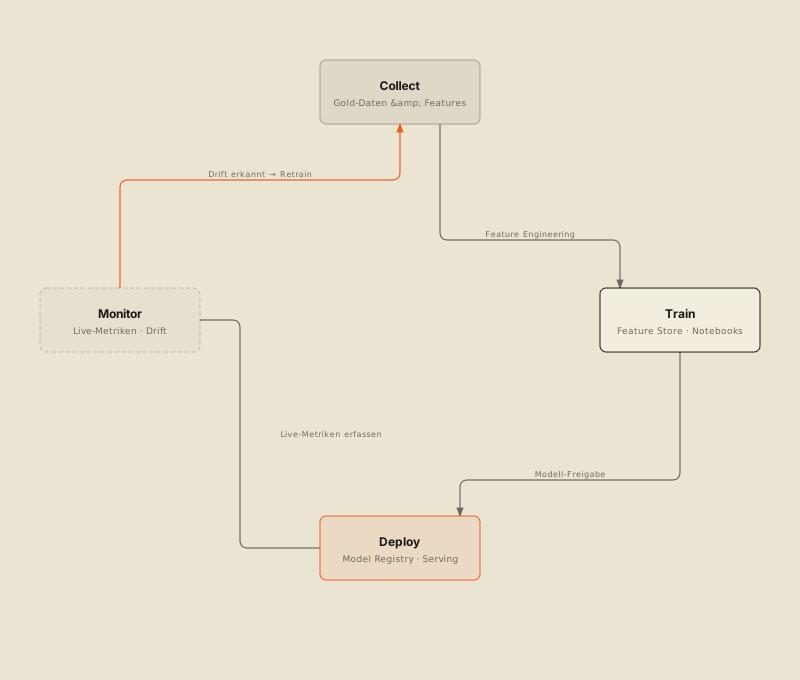
Drift-Erkennung ist der einzige Trigger, der den Kreislauf von aussen unterbricht — alles andere laeuft geplant.
12 · Wirkungsradius
Containment eines Gold-Table-Vertrags
Vier Ebenen zwischen Enterprise-IT und einem einzelnen Datenvertrag.
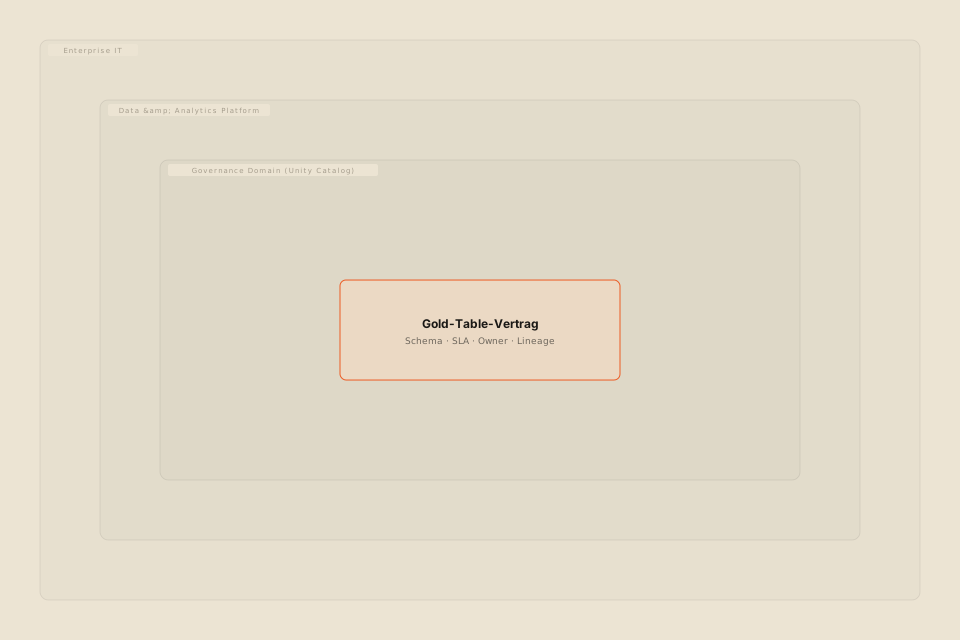
Governance aendert nie den Container, nur die innerste Zeile — genau wie beim MCP-Server selbst.
13 · Taxonomie
Taxonomie der Datendomaenen
Wie Enterprise-Daten in Domaenen und Datasets gegliedert sind.
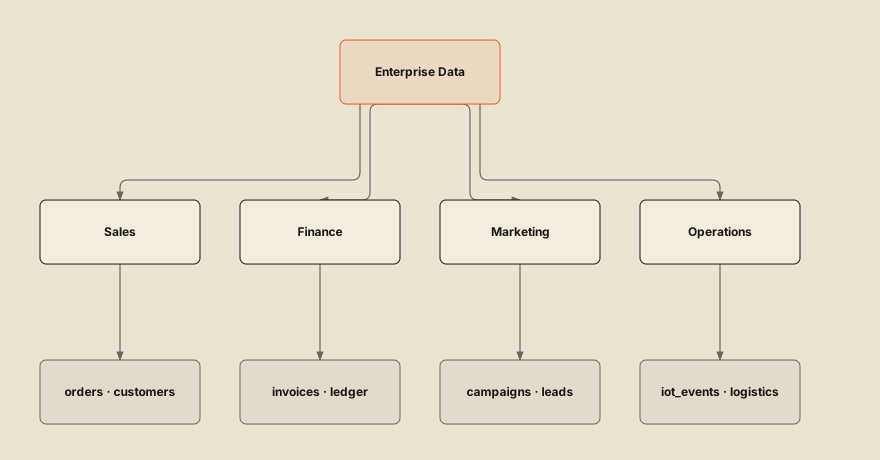
Jede Domaene besitzt ihre Datasets exklusiv — Domain-Ownership ist die Grundannahme von Data Mesh.
14 · Organisation
Data & Analytics Team
Typische Team-Struktur unter einem Chief Data Officer.
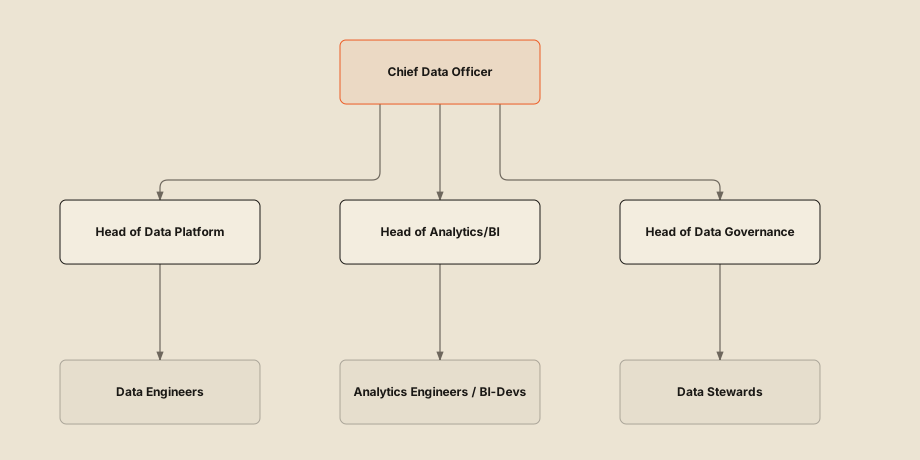
Analytics Engineering sitzt bewusst zwischen Platform und Governance — nicht unter einem der beiden.
15 · Schichten
Layered Data-Platform-Stack
Fuenf Abstraktionsebenen von Ingestion bis Consumption.
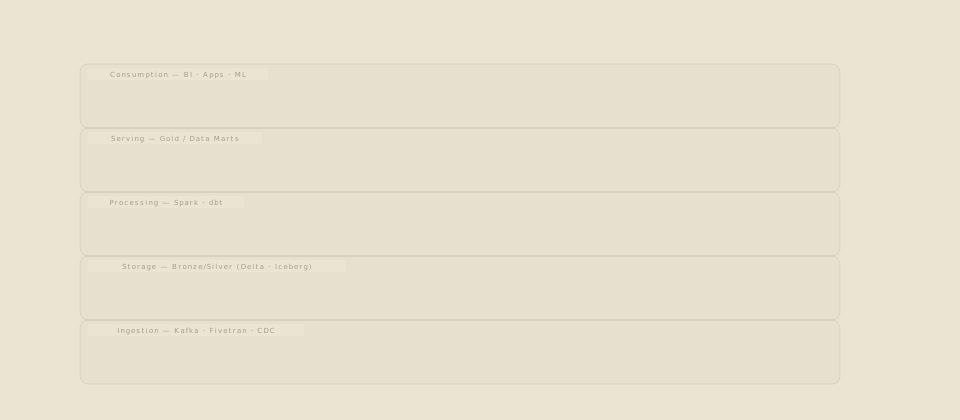
Jede Schicht kennt nur ihre direkten Nachbarn — die Consumption-Schicht weiss nichts von Kafka.
16 · Rollenabgrenzung
Ueberlappende Kompetenzprofile
Wo sich Data Engineer, Data Scientist und Analytics Engineer fachlich ueberschneiden.
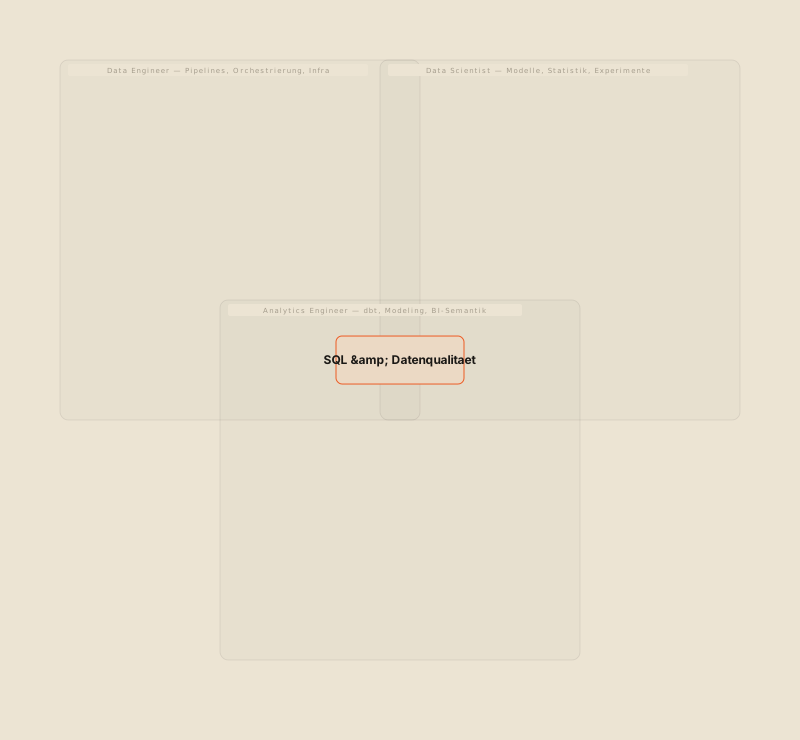
Die Schnittmenge aller drei Rollen ist klein, aber kritisch: ohne gemeinsames Verstaendnis von Datenqualitaet zerfaellt jedes Teammodell.
17 · Reifegrad
Daten-Reifegradmodell
Gaengiges CMM-basiertes 5-Stufen-Modell, wie es u.a. mit DAMA-DMBOK-Praxis kombiniert wird.
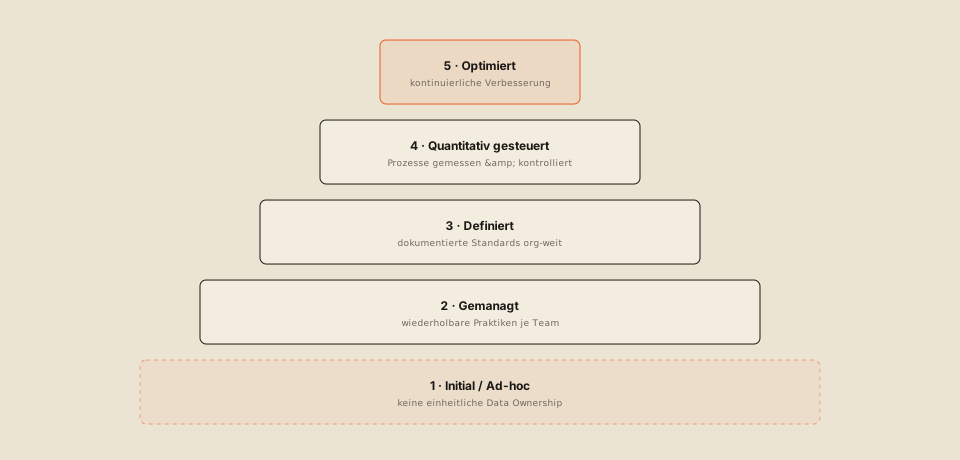
Die meisten Organisationen stecken zwischen Stufe 1 und 2 fest — Stufe 3 erfordert dokumentierte, org-weite Standards. [7][8]
18 · Marktvergleich
Umsatzvergleich Cloud-Datenplattformen
Balkenhoehe = Jahresumsatz/annualisierte Recurring Revenue in Mrd. USD.
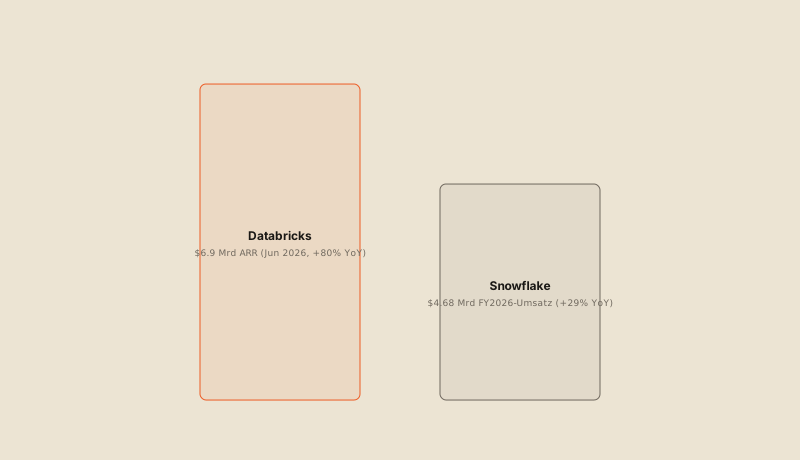
Databricks waechst schneller (+80% YoY), Snowflake bleibt die groessere oeffentliche Plattform im etablierten SQL-Workload — beide Zahlen sind Stand Sommer 2026 und aendern sich schnell. [4][5][6]
19 · Trend
Wachstum des globalen Datenvolumens
IDC Global DataSphere: von 4,3 ZB (2013) auf 175 ZB (2025, Prognose).
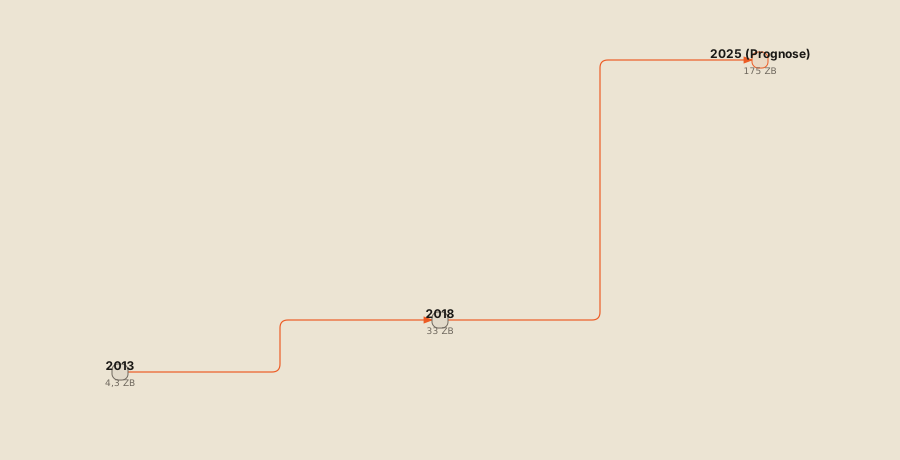
Zwischen 2013 und 2025 vervierzigfacht sich das globale Datenvolumen fast — Speicher- und Governance-Strategien muessen mit diesem Tempo mithalten. [1][2]
20 · Projektplan
Migrationsprojekt-Zeitplan
11 Wochen von Discovery bis Go-Live.
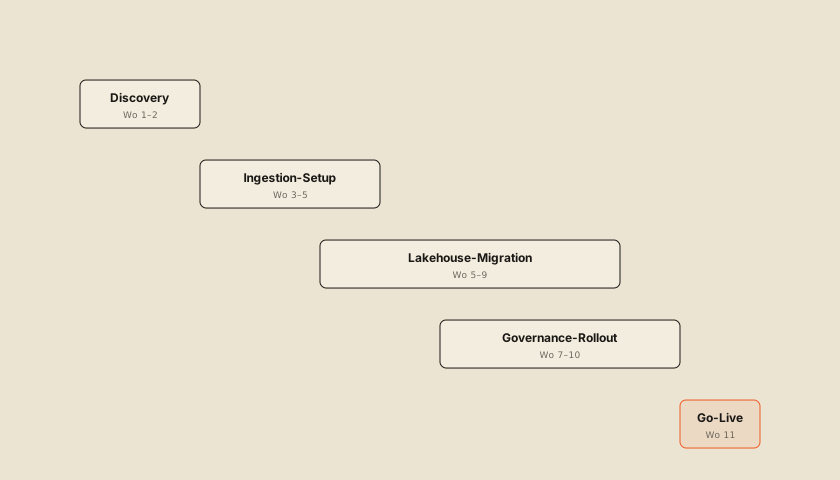
Governance-Rollout startet parallel zur technischen Migration, nicht danach — nachtraeglich eingefuehrte Policies sind ein haeufiger Grund fuer gescheiterte Rollouts.
21 · Trade-off
Kosten-Latenz-Trade-off der Speicherarchitekturen
Konzeptionelle Einordnung nach Architekturmuster — keine Benchmark-Messung.
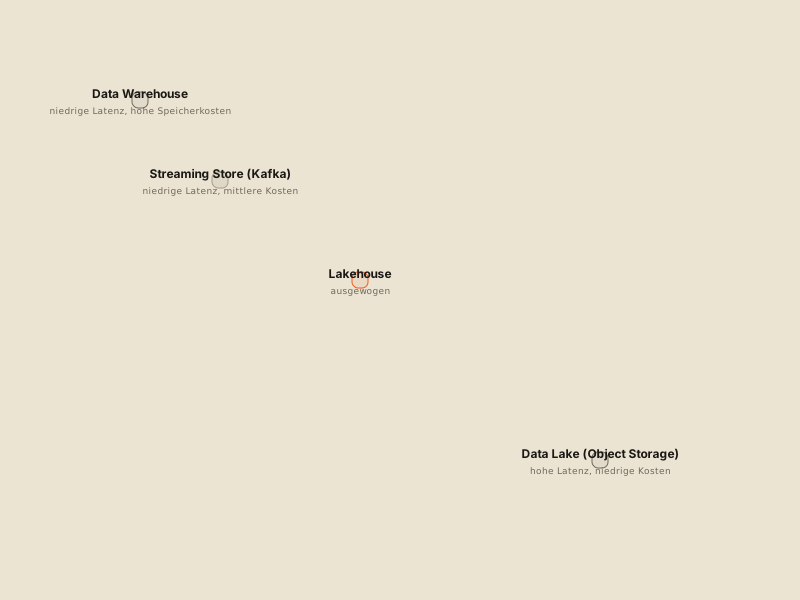
Die Lakehouse-Position ist kein Zufall: sie ist explizit als Kompromiss zwischen Data-Warehouse- und Data-Lake-Charakteristik entworfen.
22 · Executive View
Datenplattform im Ueberblick
Die Drei-Kasten-Sicht fuer Stakeholder ohne technischen Detailbedarf.
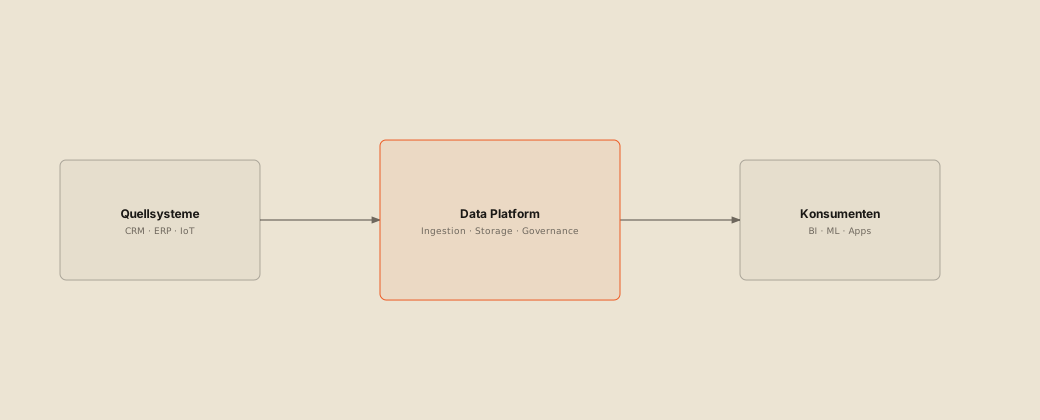
Fuer Stakeholder-Kommunikation reichen drei Kaesten — alles Weitere gehoert in die Detailarchitektur.
23 · Prozess
ELT-Transformationsprozess
Fuenf Schritte von der Extraktion bis zur Veroeffentlichung.
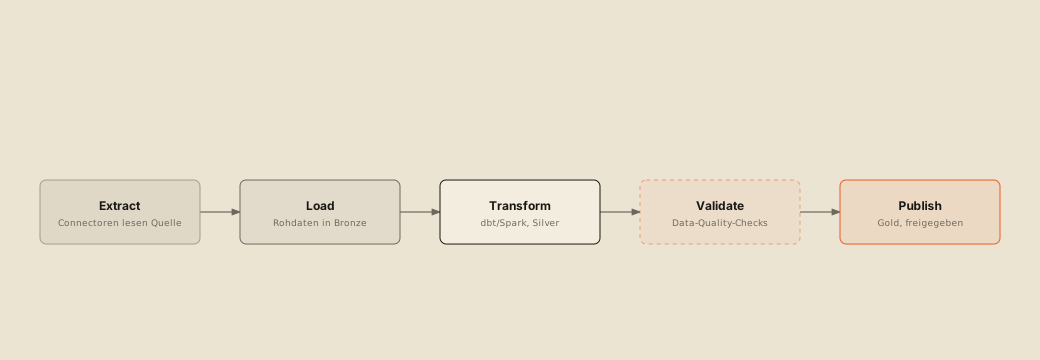
Validate steht bewusst vor Publish, nicht danach — fehlerhafte Daten sollen nie den Gold-Layer erreichen.
24 · Medallion
Bronze/Silver/Gold-Architektur
Databricks-Referenzmuster: progressive Datenqualitaet ueber drei Layer.
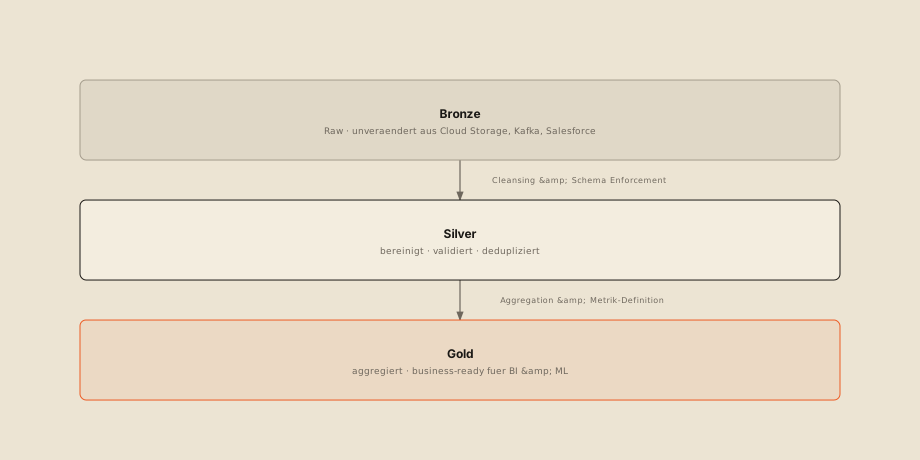
Der Pattern-Name ist produktunabhaengig: Databricks praegte den Begriff, aber er funktioniert genauso auf Snowflake oder BigQuery. [3]
25 · Datenfluss
Datenfluss durch die Plattform
Von drei Quellsystemen ueber einen Streaming-Hub zu BI und ML.
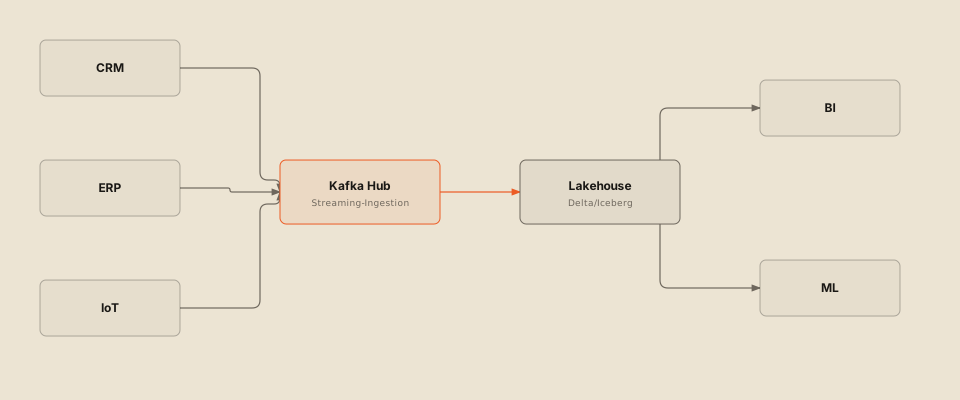
Alle drei Quellen laufen durch denselben Streaming-Hub — ein einzelner Ingestion-Pfad statt drei Punkt-zu-Punkt-Integrationen.
26 · Integration
Konnektor-Landschaft der Ingestion
Drei Konnektor-Pfade fuehren in die zentrale Integration Layer.
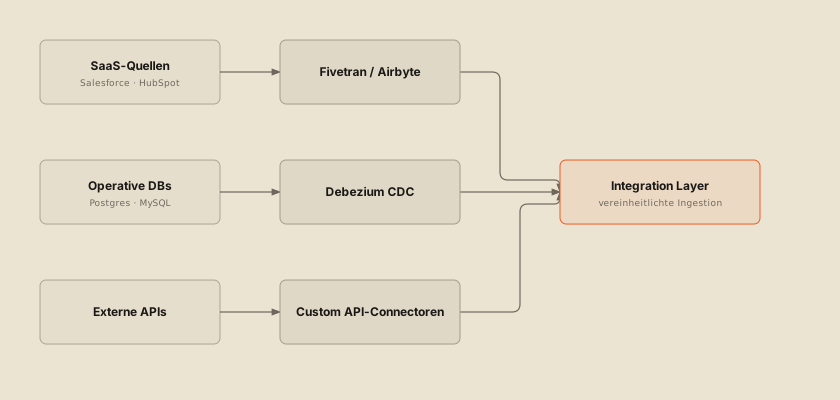
CDC deckt operative Datenbanken ab, SaaS-Connectoren die Business-Tools — beide Pfade landen in derselben Integration Layer.
27 · Governance
Zugriffsrechte nach Rolle und Datenzone
RBAC-Matrix: wer darf in welcher Medallion-Zone was tun.
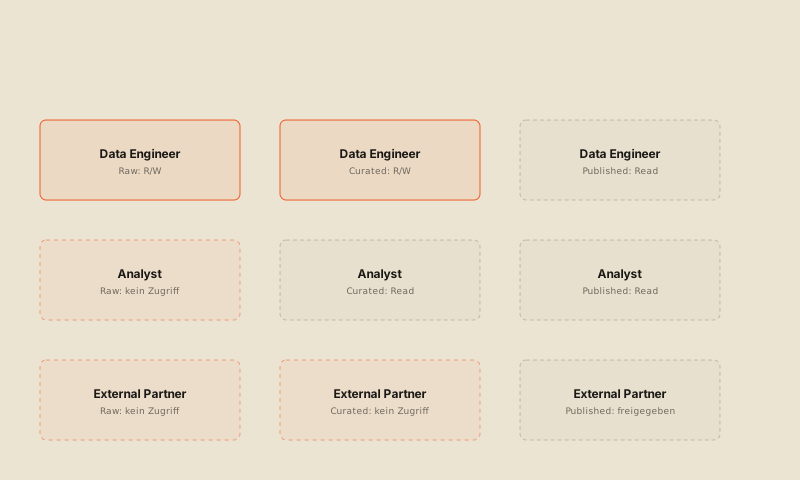
External Partner sehen ausschliesslich freigegebene Gold-Views — Raw und Curated bleiben intern, ohne Ausnahme.
Quellen
- IDC, "Data Age 2025" / Global DataSphere-Prognose — 33 ZB (2018) auf 175 ZB (2025), 61% CAGR. networkworld.com
- Global-Datasphere-Zeitreihe inkl. 4,3 ZB (2013) als Ausgangswert. researchgate.net
- Databricks Docs, "What is the medallion lakehouse architecture?" docs.databricks.com
- Snowflake, Financial Results Q4 & Fiscal Year 2026 (Umsatz $4,68 Mrd, +29% YoY). businesswire.com
- CNBC, "Databricks revenue growth tops 80% to $6.9 billion annualized" (Juni 2026). cnbc.com
- Sacra, Databricks Company Profile — annualisierte Umsatzentwicklung 2025/2026. sacra.com
- Atlan, "DAMA DMBOK Framework: An Ultimate Guide for 2026". atlan.com
- Dataversity, "Assessing Data Management Maturity Using the DAMA DMBoK Framework" (CMM-basierte 5-Stufen-Bewertung). dataversity.net
Diagramme 09, 11, 20, 21, 22, 23, 25, 26 und 27 sind konzeptionelle Illustrationen gaengiger Praxis (Rollen, Prozesse, Referenzmuster) ohne einzelne externe Quellenangabe. Alle 27 Diagramme wurden nativ ueber die MZP-Diagramm-Engine (validateDiagram/publishDiagram) gerendert, nicht handgezeichnet.