MZP · Agenten-Evals · MZP-113 · 2026-10-03
Siebter Eval-Lauf: 15 von 15 grün, erste volle LLM-Stufe
Die deterministische Stufe ist unverändert sauber: 15 Aufgaben grün, 42 Aufrufe wie am 02.10., keine Regression. Neu ist die LLM-Stufe über den ganzen Korpus statt nur über fünf Diagramm-Aufgaben. Sie zeigt, wo sich der Server gut selbst erklärt (Diagramme, Report-Artefakte) und wo nicht (Live-Daten, ASCII-Skizzen, analog-Blätter). Zwei Befunde sind echte Server-Fehler, die keine Suite sieht.
Handlungsbedarf
Kein UNEXPECTED_PASS, kein Marker zu entfernen. Aus der LLM-Stufe kommen zwei Server-Befunde, beide still (der Server meldet Erfolg oder schweigt):
- figure.svg fällt bei HTML-Entities still weg. Steht im
<svg id="az-svg">eines analog-Blatts eine HTML-Entity wie·, verwirftFigureSvgExtractordas Fragment als nicht wohlgeformt. Es entsteht wederfigure.svgnochfigure.png, der Publish meldet trotzdemFIGURE_CLEAN. Die Agenten haben die Entity aus dem Gerüst vongetCapabilityFor('analog')übernommen (dort im Kopf, außerhalb des SVG) und in die Pflicht-Legende gesetzt. So scheiterten zwei von drei Sonnet-Läufen vonart-analog-tusche. Vorschlag: Entities vor der Extraktion auflösen oder eine NoticeFIGURE_SVG_SKIPPEDausgeben. publishPagemeldet einen ungültigen Slug unstrukturiert.publishArtifactantwortet aufeval-slug.testmitINVALID_SLUG,suggestionundresolution; der Template-WegpublishPagenur mit nacktem Text. Sonnet wählte zweimal genau diesen Weg (B9 dort nur halb behoben).
Dazu kommen Schwächen der Aufgaben selbst (siehe unten, Was an den Aufgaben liegt). Dieser Lauf ändert keine Aufgaben-Dateien.
Deterministische Stufe
| Aufgabe | Familie | Status | Aufrufe | knownIssue | Kernbefund |
|---|---|---|---|---|---|
art-a11y-check | artifact | grün | 1 | — | A11Y_IMAGE_ALT als WARNING, 1 Element, ok bleibt true |
art-analog-tusche | artifact | grün | 3 | — | 4 Schwellstriche, FIGURE_CLEAN; Seite und figure.svg tragen die Tusche-Kontur |
art-asset-bundle | artifact | grün | 3 | — | 3 Dateien, erreichbar, Render sauber |
art-broken | artifact | grün | 2 | — | ok:false mit allen vier Codes, keine Seite entstanden |
art-live-report | artifact | grün | 3 | — | Live-Daten stats im Snapshot (449 Seiten), Render sauber |
art-patch | artifact | grün | 5 | — | Patch lässt app.js stehen, der Diff zeigt nur index.html |
art-report | artifact | grün | 3 | — | validate → stagingToken → publish, Render sauber |
dia-architecture-auto | diagram | grün | 3 | — | 3 Kreuzungen, 8 Überlappungen, 24 Knicke (02.10.: 3 / 8 / 24) |
dia-ascii-architecture | diagram | grün | 3 | — | 4 Knoten, 3 Kanten, 2 Zonen; 1 Lage-Vorgabe, 0 unerfüllt; Layout sauber |
dia-constraints | diagram | grün | 2 | — | 1 Wunsch, 0 unerfüllt; 0 Kreuzungen, 4 Knicke |
dia-diff | diagram | grün | 4 | — | diffDiagram meldet genau 1 Knoten + 1 Kante |
dia-mermaid-flow | diagram | grün | 3 | — | 7 Knoten, 1 Zone; 2 Kreuzungen, 12 Knicke wie am 02.10. |
dia-quadrant-longlabels | diagram | grün | 2 | — | textInsideViewBox sauber (viewBox 960 × 540) |
dia-radar-wrapped | diagram | grün | 3 | — | typeBlocks entpackt (INFO), Achsentext im SVG |
edge-invalid-slug | edge | grün | 2 | — | INVALID_SLUG strukturiert, suggestion eval-slug-test |
42 MZP-Aufrufe in den Aufgaben, genau wie am 02.10.; alle Layout-Kennzahlen sind unverändert (dia-architecture-auto 3 / 8 / 24, dia-mermaid-flow 2 / 0 / 12). Beim Aufräumen am Anfang war Produktion rund 40 Sekunden nicht erreichbar: 16 von 17 parallel gesendeten deletePage kamen als HTTP 502 zurück. Danach wurde nur noch einzeln gesendet, alle 17 Slugs waren schon weg. Ob die parallelen Aufrufe den Ausfall ausgelöst haben, ist nicht geklärt. ms ist nicht gemessen.
LLM-Stufe: erster Volllauf
Erstmals alle 15 Aufgaben, je drei Läufe mit Sonnet 5 und Haiku 4.5, abgeschottet wie am 28.09. (nur ToolSearch und MZP-Tools). Gemessen sind 87 von 90 Läufen: Der Lauf brach zweimal ab, weil das Nutzungslimit auch die Helfer-Sitzungen für Aufräumen und Nachprüfung stoppte (NO_CALL). Es fehlen die drei Haiku-Läufe von edge-invalid-slug, ein Sonnet-Lauf derselben Aufgabe ist VERIFY_ERROR (nicht gemessen). Vor dem Lauf wurde ein Fehler im Runner behoben: run-llm.py schnitt das Frontmatter von dia-ascii-architecture an dem --- in der ASCII-Skizze ab; die Aufgabe hätte sonst keinen Nachprüf-Schritt gehabt.
| Aufgabe | Sonnet 5 Erfolg | Sonnet 5 Aufrufe | Haiku 4.5 Erfolg | Haiku 4.5 Aufrufe |
|---|---|---|---|---|
art-a11y-check | nur gemessen (+3 ungültig) | 1 (0–2) | nur gemessen (+3 ungültig) | 0 (0–0) |
art-analog-tusche | 1/3 | 4 (4–5) | 0/3 | 4 (3–5) |
art-asset-bundle | 2/2 (+1 ungültig) | 1 (0–2) | 1/1 (+2 ungültig) | 1 (1–1) |
art-broken | 0/0 (+3 ungültig) | 0 (0–0) | 1/3 | 0 (0–1) |
art-live-report | 2/3 | 4 (1–6) | 0/3 | 1 (1–3) |
art-patch | 0/1 (+2 ungültig) | 0 (0–0) | 0/3 | 0 (0–0) |
art-report | 3/3 | 2 (2–2) | 3/3 | 1 (1–1) |
dia-architecture-auto | 2/2 (+1 ungültig) | 2 (0–2) | 2/3 | 5 (3–6) CALLS_UP |
dia-ascii-architecture | 0/3 | 5 (1–10) | 2/3 | 9 (5–9) |
dia-constraints | nur gemessen (+3 ungültig) | 3 (2–3) | nur gemessen (+3 ungültig) | 1 (1–2) |
dia-diff | 3/3 | 2 (2–2) | 3/3 | 2 (2–3) |
dia-mermaid-flow | 3/3 | 2 (2–3) | 3/3 | 1 (1–1) |
dia-quadrant-longlabels | 3/3 | 3 (2–3) | 3/3 | 3 (2–6) |
dia-radar-wrapped | 3/3 | 3 (2–3) | 3/3 | 4 (3–4) |
edge-invalid-slug | 0/2 (+1 ungültig) | 2 (0–2) | — | — |
Erfolg = bestandene Nachprüfung / gemessene Läufe; „ungültig“ = Läufe, die der Runner nicht misst (Agent griff zu einem gesperrten Werkzeug). Aufrufe als Median mit Spanne (min–max) über alle drei Läufe.
Vergleich mit der LLM-Baseline (Q18). Nur die fünf Diagramm-Aufgaben × Haiku sind vergleichbar. Erfolg 14/15 wie am 30.09., also kein SUCCESS_DOWN. Eine CALLS_UP-Warnung: dia-architecture-auto × Haiku braucht im Median 5 statt 2 Aufrufe, mit 6 abgelehnten Eingaben (DIAGRAM_INVALID). dia-quadrant-longlabels fällt von 4 auf 3 Aufrufe, dia-radar-wrapped bleibt bei 4.
Wo sich der Server gut erklärt. art-report, dia-diff, dia-mermaid-flow, dia-quadrant-longlabels und dia-radar-wrapped bestehen mit beiden Modellen jeden Lauf, meist mit 1–3 Aufrufen.
Wo nicht.
art-live-report(Sonnet 2/3, Haiku 0/3): Die Agenten finden den Live-Daten-Mechanismus (E11,liveData) nicht. Ein Sonnet-Lauf lasgetCapabilities, schloss auf „kein öffentlicher Zähl-Endpunkt“ und brach ohne Publish ab. Die Fähigkeit ist dort, wo Agenten zuerst suchen, nicht sichtbar.dia-ascii-architecture(Sonnet 0/3, Haiku 2/3): Die ASCII-Grammatik ist schwer zu treffen. Ein Sonnet-Lauf schickte achtmal eine Skizze anpublishDiagramund scheiterte jedes Mal (ASCII_EDGE_DANGLING,ASCII_BOX_OVERLAP), ohne vorher zu validieren. Die Fehlermeldungen nennen Zeile und Spalte, reichen aber offenbar nicht.art-analog-tusche(Sonnet 1/3, Haiku 0/3): Bei Sonnet der figure.svg-Befund oben. Haiku nahm in allen drei Läufen den Diagramm-Weg (DIAGRAM_INVALID) statt eines analog-Blatts.
Was an den Aufgaben liegt. Zwölf Läufe sind ungültig, weil der Agent zu Bash oder Glob griff. Drei Prompts lesen sich so, als lägen Dateien bereit: art-a11y-check („ein Bild bild.svg“), art-broken („als eine einzige Datei index.html“), art-patch („mit einer eingebundenen app.js“) und art-asset-bundle (Platzhalter-Bild erzeugen). art-patch kam deshalb in keinem Lauf zum Publish (0/4 gemessen). Bei art-broken fehlt dem Prompt der kaputte Inhalt; ein Haiku-Lauf „bestand“, indem er eine eigene saubere Seite schrieb. Das misst B1 nicht. Diese Prompts sollten den Inhalt nennen oder ausdrücklich sagen, dass der Agent ihn selbst schreibt.
Verlauf
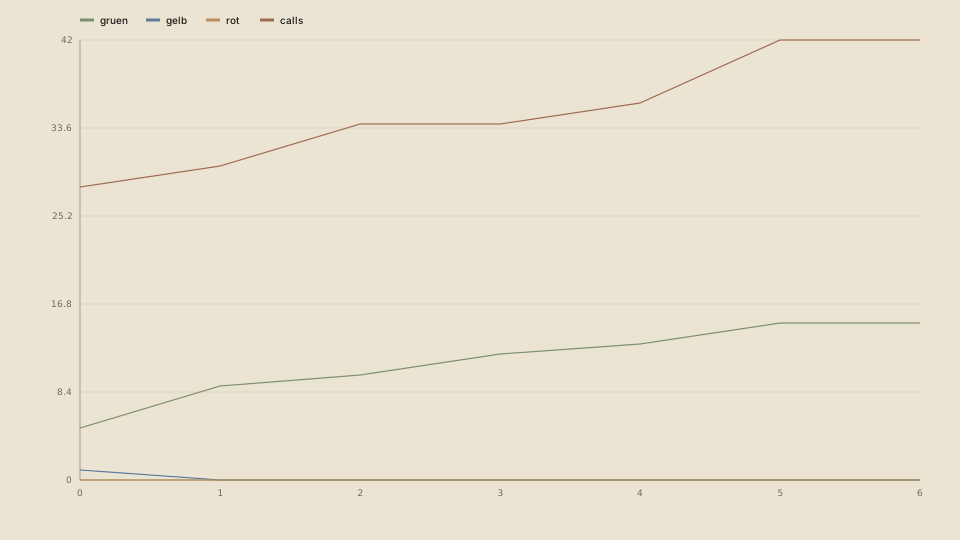
line, Slug mzp-eval-trend-2026-10-03). Aufrufe 28 → 30 → 34 → 34 → 36 → 42 → 42, grün 5 → 9 → 10 → 12 → 13 → 15 → 15, gelb 1 → 0, rot 0. Die Historie mit den LLM-Werten je Modell steht in results.json.